Tech & DevOps HubEspace Tech & DevOps: Explorez le monde du Dev, du Cloud et des outils DevOps à travers nos articles et discussions Explore the world of development, the cloud and DevOps tools
Intégration continue: la branche develop

Nous traiterons également l'averissement "Dependency version cannot be determined" présent dans les logs.
Mise en place de l'architecture de base
Avant de plonger dans la création de modèles ou la gestion des variables, commençons par poser les fondations de nos pipelines.
Par la suite, et au fur et à mesure des articles, nous créerons et utiliserons d'autres dossiers, tels que les templates, les variables, etc.
1. Créer l'arborescence GitLab
- Créez le fichier .gitlab-ci.yml,
- Le dossier .gitlab,
- Son sous-dossier jobs ainsi que ses pipelines
FLASHCARDS
├───.gitlab
│   └─ jobs
│       ├── develop.yml
│       ├── staging.yml
│       └── main.yml
└─.gitlab-ci.yml
2. Déclarer les premiers [stages] et les [includes]
Analyse des stages pour [develop]
Java 17 + Maven + Spotless Build + Tests  JaCoCo   : test
CodeQL, qui mérite une discussion à part           : security
Trivy                                              : security
stages:
  - test
  - security

include:
  - local: '.gitlab/jobs/develop.yml'
  - local: '.gitlab/jobs/staging.yml'
  - local: '.gitlab/jobs/main.yml'
3. Ajouter les fichiers pipelines
develop-test:
  stage: test
  script:
    - echo "develop"
  rules:
    - if: '$CI_COMMIT_BRANCH == "develop"'
Respecter la stratégie Gitlab Flow
les fonctionnalités sont développées à part, puis fusionnées de branche en branche.
Voir aussi: gitlab-flow-best-practices
on:
  push:
    branches: [ develop ]
  pull_request:
    branches: [ develop ]
4. Élargir la validation aux autres types de branches
Contexte: Dans l'état actuel, le pipeline ne démarrera pas sur la branche develop. La raison est que l'on ne pousse jamais directement vers cette branche.Ajout de la règle suivant la convention minimale standard
- if: '$CI_COMMIT_BRANCH =~ /^(feature|fix|refactor|chore)\/.+$/'
- when: never
fix/ → corrections
refactor/ → refactoring sans changement fonctionnel
chore/ → maintenance, dépendances, configuration, tooling
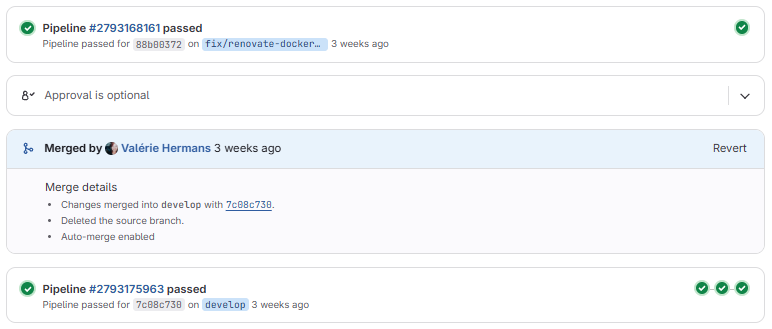
Et ce sera le sujet d'un prochain article où, nous verrons comment verrouiller cette étape pour forcer le fait qu'un pipeline doit réussir ("Pipelines must succeed") avant de d'activer le bouton de fusion.
[develop] Build des tests
La question fondamentale à se poser est simple : que doit faire ce premier job? Sur la branche develop, l'objectif principal est d'obtenir un feedback rapide.
Ce job aura donc pour mission de compiler l'application et d'exécuter l'ensemble des tests (unitaires et d'intégration).
develop-build:
  stage: test
  cache:
    key:
      files:
        - pom.xml
        - .mvn/wrapper/maven-wrapper.properties
    paths:
      - .m2/repository/
    policy: pull-push
  image: "maven:3.9.11-eclipse-temurin-17"
Commençons par définir l'environnement d'exécution et une stratégie de cache pour accélérer les futurs builds:
La clé du cache (key:files) ne sera invalidé et mis à jour que si le fichier pom.xml ou la configuration du wrapper Maven sont modifiés.
  variables:
    SPRING_PROFILES_ACTIVE: dev
    SPRING_DATASOURCE_URL: jdbc:h2:mem:itdb;DB_CLOSE_DELAY=-1
    SPRING_DATASOURCE_DRIVER_CLASS_NAME: org.h2.Driver
    SPRING_DATASOURCE_USERNAME: sa
    SPRING_DATASOURCE_PASSWORD: ""
  script:
    - chmod +x mvnw
    - ./mvnw -B dependency:resolve
    - ./mvnw -B dependency:go-offline
    - ./mvnw spotless:check
    - chmod +x ci-scripts/test.sh
    - ./mvnw -B clean verify jacoco:report
  artifacts:
    when: always
    paths:
      - target/site/jacoco/
      - .m2/repository/
    expire_in: 1 hour
  rules:
    - if: '$CI_COMMIT_BRANCH == "develop"'
    - if: '$CI_COMMIT_BRANCH =~ /^(feature|fix|hotfix|refactor|chore)\/.+$/'
    - when: never
Il pourra également être réutilisé par d'autres jobs.
Le job se termine par l'ajout des règles, comme ajoutées plus haut.
Résultat des logs
- .m2/repository/
- target/site/jacoco/
No URL provided, cache will
not be uploaded to shared cache server.[INFO] BUILD SUCCESS
Saving cache for successful job
Creating cache 0_pom_-79def43a17a610d2f6e9cd36e0a5c031ce59b714-4-protected...
.m2/repository/: found 6087 matching artefact files and directories
No URL provided, cache will not be uploaded to shared cache server.
Cache will be stored only locally. Created cache
Uploading artifacts for successful job
target/site/jacoco/: found 47 matching artifact files and directories
.m2/repository/: found 6087 matching artifact files and directories
Uploading artifacts as "archive" to coordinator... 201 Created
correlation_id=a30383ad6cbfb732-BRU id=16072721047 status=201 token=72_rTjDeeConcept de lecture des jobs GitLab
Maintenant que nous avons un aperçu du premier job, et avant d'entamer le second, explorons l'un des concepts les plus importants de GitLab CI.
Cela m'a un peu dérouté au début, et je trouve que cela vaut la peine d'une petite explication. La règle est simple: "le pipeline ne se lit pas de haut en bas"
Je répète : les pipelines ne se lisent pas de haut en bas.
Et chacuns d'eux décrit :
- son stage, ses dépendances (needs) et les artefacts qu'il produit ou consomme
- ses règles d'exécution
- Il lit tout le fichier .gitlab-ci.yml.
- Il construit ensuite un graphe d'exécution à partir des stages, needs et rules
- Il exécute les jobs en respectant ce graphe
Ce sont les stages et les relations needs qui déterminent le graphe d'exécution.
Respecter l'ordre des stages
Ils doivent être déclarés dans l'ordre chronologique exact dans lequel on souhaite que les tâches s'exécutent.
L'utilisation de needs permet toutefois de construire des dépendances plus fines et de démarrer certains jobs avant la fin complète du stage précédent.
Deux règles s'appliquent
- Tous les jobs d'un même stage s'exécutent en parallèle
- Un stage ne démarre que lorsque le stage précédent est terminé (sauf utilisation particulière de needs)
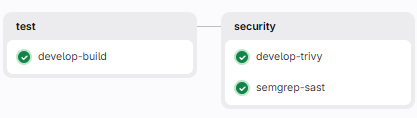
Les stages organisent l'exécution et permettent le parallélisme
stages:
  - test
  - security
Stage test
└── develop-build

Stage security
├── develop-trivy
└── semgrep-sast
          Stage test
      ┌─────────────────┐
      │ develop-build   │
      └────────┬────────┘
               │
               ▼
        Stage security
      ┌────────┴─────────┐
      ▼                  ▼
develop-trivy      semgrep-sast
L'importance de "needs"
develop-trivy:
  stage: security
  needs:
    - develop-build
Le job en cours (develop-trivy) va attendre que le job spécifié (develop-build) dans "needs" soit terminé.
Avec needs : un job du stage B peut démarrer dès que le job du stage A dont il dépend est terminé, même si d'autres jobs du stage A tournent encore.
develop-build:
  //..
  artifacts:
  when: always
  paths:
    - target/site/jacoco/
    expire_in: 1 hour
autre-job:
  needs:
    - job: develop-build
      artifacts: true
Voici une illustration concrète pour bien comprendre la différence
Imaginez que le stage de test contient deux jobs: un job de tests unitaires très rapide (1 min) et un job de tests QA très long (15 min):
STAGES:       [test]                                 [deploy]
JOBS:         ├── unit-test (1 min) ───► (terminé)      └── deploy-app (attend 15 min !)
              └── qa-test   (15 min)  ──────────────────► (fin)
Un problème se pose: le job "deploy-app" serait prêt dès la première minute, car les tests unitaires ont réussi.
Et pourtant, GitLab le bloque et l'oblige à attendre 14 minutes de plus, le temps que le job "qa-test" se termine.
Si on ajoute needs: unit-test au job "deploy-app", on crée un raccourci :
STAGES:       [test]                                 [deploy]
JOBS:         ├── unit-test (1 min) ─(déclenche) ───────► deploy-app (démarre à la min 1 !)
              └── qa-test   (15 min)  ──────────────────► (tourne encore en arrière-plan)
Résultat : le déploiement commence dès la fin de la première minute (si toutes ses autres conditions et dépendances sont satisfaites).
On n'attend plus la fin du long traitement QA pour avancer dans le pipeline: le déploiement démarre dès que "unit-test" est terminé avec succès et, sous réserve qu'aucune autre dépendance ne le bloque.
[develop] Trivy Scan (FileSystem)
Maintenant que nous avons compris ces quelques concepts de base, penchons-nous sur le deuxième job de la branche [develop].develop-trivy:
stage: security
needs:
- job: develop-build
artifacts: true
image:
name: aquasec/trivy:0.72.0
entrypoint: [""]
cache:
- key: trivy-db
paths:
- .trivycache/
policy: pull-push
variables:
TRIVY_CACHE_DIR: "$CI_PROJECT_DIR/.trivycache"
script:
trivy fs \
--severity HIGH,CRITICAL \
--format table \
--scanners vuln,misconfig \
--skip-dirs ".trivycache" \
--skip-dirs "target" \
--cache-dir "$TRIVY_CACHE_DIR" \
--offline-scan \
--exit-code 0 \
--no-progress \
.
artifacts:
when: always
paths:
- trivy-report.json
rules:
- if: '$CI_COMMIT_BRANCH == "develop"'
- if: '$CI_COMMIT_BRANCH =~ /^(feature|fix|hotfix|refactor|chore)\/.+$/'
- when: never
Le contexte Trivy
Avec needs, on attend que le job develop-build se termine avant de lancer le scan Trivy.
- trivy-report.json
Pousser automatiquement les résultats dans un outil de gestion des vulnérabilités centralisé (SonarQube).
Ou, avec un script maison, déclencher une alerte automatisée uniquement si une faille de niveau CRITICAL avec un correctif disponible est détectée.
Gestion de l'erreur "429 Too many requests"
FATAL Error
remote Maven repository returned 429 Too Many Requests
...
The repository blocks all subsequent requests from
this IP until the block clears.la dépendance "spring-data-bom". Les serveurs de Maven Central, voyant passer des requêtes répétées et non authentifiées provenant de l'IP du runner, ont activé leur mécanisme de protection (Rate Limiting) et bloqué le pipeline.
Résolution, en amont et mode hors-ligne
c'est le job de build Maven qui va télécharger proprement toutes les dépendances une bonne fois pour toutes, puis les léguer à Trivy.
./mvnw -B dependency:resolve
./mvnw -B dependency:go-offline- job: develop-build
artifacts: true267.8M .m2/repository
Spring Data BOM available for TrivySchéma des relations entre develop-build et develop-trivy
develop-build
  ├── dependency:resolve
  ├── dependency:go-offline
  ├── Exécution des tests & JaCoCo
  └── Export du dossier .m2/repository/
          │
          │  [Transmission via Artifact GitLab]
          ▼
    develop-trivy
        │
        ├── Récupération du dossier .m2/
        ├── Téléchargement/Actualisation de la Trivy DB (cache dédié)
        ├── Activation du mode --offline-scan
        └── Exécution de : trivy fs --format table
                │
                ├── Analyse du pom.xml    ➔ 0 vulnérabilité
                └── Analyse du Dockerfile ➔ 0 mauvaise configuration
son repository local est ensuite transmis à Trivy
Logs et analyse du résultat de Trivy
234.65 KiB / 234.65 KiB [--------------------------------------------------------->] 100.00% ? p/s ?
234.65 KiB / 234.65 KiB [-----------------------------------------------] 100.00% 7.10 MiB p/s 200ms
2026-08-24T15:57:08Z	WARN	[pom] Dependency version cannot be determined.
Child dependencies will not be found.	details="https://trivy.dev/docs/v0.74/guide/coverage/language/java#empty-dependency-version"
2026-08-24T15:57:08Z	INFO	Number of language-specific files	num=1
2026-08-24T15:57:08Z	INFO	[pom] Detecting vulnerabilities...
2026-08-24T15:57:08Z	INFO	Detected config files	num=1
 Report
┌────────────┬────────────┬─────────────────┬───────────────────┐
│   Target   │    Type    │ Vulnerabilities │ Misconfigurations │
├────────────┼────────────┼─────────────────┼───────────────────┤
│ pom.xml    │    pom     │        0        │         -         │
├────────────┼────────────┼─────────────────┼───────────────────┤
│ Dockerfile │ dockerfile │        -        │         0         │
└────────────┴────────────┴─────────────────┴───────────────────┘

Legend:
- '-': Not scanned
- '0': Clean (no security findings detected)
Saving cache for successful job
Creating cache trivy-db-4-protected...
.trivycache/: found 746 matching artifact files and directories
No URL provided, cache will not be uploaded to shared cache server. Cache will be stored only locally.
Created cache

Uploading artifacts for successful job...
.trivycache/: found 746 matching artifact files and directories
Uploading artifacts as "archive" to coordinator... 201 Created  correlation_id=a3038dc86b61ba70-BRU id=16072721048 status=201 token=72_Vofrys
Le résultat indique:
0 vulnérabilité dans les dépendances que Trivy a pu identifier et analyser,
0 erreur de configuration (misconfiguration) détectée dans les fichiers de configuration analysés.
Le warning Maven rappelle toutefois qu'une partie de l'arbre de dépendances peut ne pas avoir pu être résolu.
Trivy peut afficher le warning suivant:
WARN [pom] Dependency version cannot be determined.
Child dependencies will not be found.
- Le POM parent permettant de déterminer la version n'est pas accessible.
- La dépendance possède une contrainte stricte, avec plusieurs versions possibles.
Dans cas-ci, la raison est que certaines dépendances ont été explicitement surchargées afin de corriger les vulnérabilités identifiées précédemment par Trivy.
Voir aussi: Comment fixer-les-vulnerabilites-trivy-d-une-application-java-springboot pour comprendre comment Trivy fonctionne avec les dépendances.
Le job se termine par la mise en cache de la base de données des vulnérabilités
Saving cache for successful job
Creating cache trivy-db-4-protected...
.trivycache/: found 746 matching artifact files and directories
Created cache

Uploading artifacts for successful job...
.trivycache/: found 746 matching artifact files and directories
Uploading artifacts as "archive" to coordinator... 201 Created ..le dossier .trivycache/ contenant les définitions de vulnérabilités est stocké localement sur notre runner.
Trivy n'aura pas besoin de retélécharger toute sa base de données, ce qui rendra le scan de sécurité instantané.
"Semgrep" pour l'analyse SAST (Java)
Il fait partie des analyzers officiels utilisés par GitLab SAST. et, est basé sur Semgrep OSS et sur un jeu de règles géré par GitLab.
Il dispose d'un ensemble de règles permettant d'identifier différents patterns de vulnérabilités et permet également de définir des règles personnalisées.
Deux manières d'intégrer cet outil à nos pipelines
develop-semgrep:
  stage: security
  image:
    name: semgrep/semgrep:1.169.0
    entrypoint: [""]
  script:
    - semgrep --config=auto .
include:
  //..
  - component: gitlab.com/components/sast/sast@3.4.0
- Il exécute Semgrep et génère un rapport SAST au format GitLab
- Il remonte les vulnérabilités dans Security, les MR, les tableaux de bord,...
Mise en place du composant
stages:
  - test
  - security
include:
  - component: gitlab.com/components/sast/sast@3.4.0
L'ajouter dans ce fichier nous évite de le configurer dans chaque branche.
Le job sera ensuite exécuté selon ses propres règles.
semgrep-sast:
  stage: security
  variables:
    SAST_EXCLUDED_PATHS: "spec,test,tests,tmp,target,load-test"
    SAST_EXCLUDED_ANALYZERS: "spotbugs"
    SECURE_LOG_LEVEL: "info"
utilisez : SECURE_LOG_LEVEL: debug
SpotBugs étant déjà exécuté dans le job "build Maven" du projet,
je le désactive ici afin d'éviter deux analyses similaires
Par défaut, il exclut déjà les répertoires "spec,test,tests,tmp"
On lui ajoute simplement les dossiers "target,load-test", spécifique à notre projet.
Décryptage du résultat du log
Checking out fec8f53a as detached HEAD (ref is develop)...
Removing "..\\..\\..\\cache\\val7304\\flashcards\\trivy-db-4-protected\\cache.zip"

Downloading artifacts for develop-build (16072721047)...
Direct download from cdn.artifacts.gitlab-static.net
Downloading artifacts from coordinator... ok
Executing "step_script" stage of the job script
Using effective pull policy of [always] for container registry.gitlab.com/security-products/semgrep:6
Using docker image sha256:177df3c8e9bdef43cf6a5e7c451074a76105c8b29392352741687c0f69ae8461
                                                           for registry.gitlab.com/security-products/semgrep:6 with digest...
$ /analyzer run
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶ ┌─────────────┐
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶ │ Scan Status │
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶ └─────────────┘
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶   Scanning 3772 files with 592 Code rules:
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶   Language      Rules   Files          Origin   Rules
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶  ─────────────────────────────        ────────────────
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶          2      31          Custom     592
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶   java            102      21
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶   yaml              1      17
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶   js               96       1
[INFO] [Semgrep] [2026-08-24T16:02:31Z] ▶
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶ ┌──────────────┐
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶ │ Scan Summary │
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶ └──────────────┘
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶  Scan completed successfully.
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶  • Findings: 0 (0 blocking)
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶  • Rules run: 201
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶  • Targets scanned: 48
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶  • Parsed lines: ~100.0%
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶  • Scan skipped:
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶    ◦ Matching --exclude patterns: 3
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶    ◦ Files larger than  files 1.0 MB: 58
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶    ◦ Files matching .semgrepignore patterns: 12
[INFO] [Semgrep] [2026-08-24T16:02:34Z] ▶ Ran 201 rules on 48 files: 0 findings.
[INFO] [Semgrep] [2026-08-24T16:02:36Z] ▶ Creating report

Uploading artifacts for successful job
gl-sast-report.json: found 1 matching artifact files and directories
Sur les 592 règles initialement disponibles dans le jeu managé de GitLab, Semgrep a identifié les langages présents dans le code et a exécuté 201 règles ciblées sur 48 fichiers éligibles. Et le verdict tombe avec 0 vulnérabilité détectée.
Les résultats SAST peuvent également être exploités par les fonctionnalités de sécurité GitLab, notamment les vues de vulnérabilités et les Merge Requests.
→ onglet "job" (volet de droite)
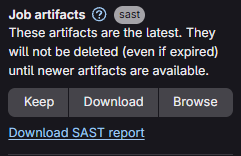
Voir ou télécharger le rapport gl-sast-report.json directement en ligne via le bouton Browse
À ce stade du projet, notre branche develop (ainsi que toutes les branches de fonctionnalités feature/* associées) bénéficie d'une couverture industrielle complète à chaque commit :
des contrôles de qualité (Spotless, tests, JaCoCo...).
d'un premier scan de sécurité avec Trivy.
d'une analyse SAST intégrée grâce à Semgrep.
Vue du pipeline